Диагностика компонентов

Этот рецепт показывает, как собрать диагностическую информацию о кластере Stackland с помощью утилиты sladm и использовать ее для поиска ошибок и их причин.
Сбор диагностической информации
Для сбора диагностической информации используется команда sladm diag — она создает архив diagnostics-<дата>-<время>.tar.gz, который содержит полный снимок состояния кластера на момент запуска. Этот архив можно использовать как источник информации для самостоятельной диагностики, а также при обращении в техническую поддержку.
Совет
Более подробную информацию об использовании команды sladm diag вы можете найти в статье Диагностика и устранение неполадок.
Как запустить сбор диагностики
Команду sladm diag можно запустить:
-
без параметров, если запуск происходит из той же директории, откуда осуществлялась инсталляция;
-
с параметрами, если запуск происходит из другой директории.
Используйте команду:
sladm diag \
  --artifacts-dir /path/to/_out \
  --install-log /path/to/install.log
-
--artifacts-dir— путь к папке_out, созданной при установке; -
--install-log— путь к лог-файлу установки.
Состав диагностического архива
Распакуйте архив и изучите его структуру:
tar -xvf diagnostics-*.tar.gz
tree
Архив состоит из следующих основных директорий:
k8s/
Диагностические данные Kubernetes-уровня: состояние объектов кластера, логи, события и конфигурации.
-
Ресурсы кластера
cluster/— содержит YAML-манифесты ресурсов кластера. Включает стандартные ресурсы Kubernetes и CRD кластера Stackland.-
Конфигурации компонентов
*configs/main.yaml— текущие настройки каждого компонента платформы:iamconfigs,consoleconfigs,dnsconfigsи других. -
Статус установки компонентов
componentinstallations/— текущая фаза и сообщение для каждого компонента:certificate-manager-main.yaml,console-main.yaml,dns-main.yamlи других. -
Описание компонентов
components/— метаданные о каждом компоненте:ai-studio.yaml,certificate-manager.yaml,console.yamlи других. -
Состояние платформы
platformconfigs/main.yaml— канал обновлений, реестр образов, статус установки. -
Окружение платформы
platformenvironments/main.yaml— эндпоинт API-сервера, домен кластера, StorageClass по умолчанию. -
Доступные обновления
availablereleaseses/main.yaml— список доступных версий Stackland с датами публикации. -
Узлы кластера
nodes/— стандартная информация об узлах кластера Kubernetes. -
Управление доступом
clusterroles/,clusterrolebindings/,clusteraccessbindings/,gizmoaccessbindings/,resourcetypeaccessbindings/— полная картина кластерных прав. -
Сертификаты
clusterissuers/stackland-default.yaml— эмитент сертификатов уровня кластера по умолчанию. -
Политики безопасности
clusterpolicysets/stackland-default.yaml— набор политик безопасности кластера. -
Каталоги образов
clickhouseimagecatalogs/,kafkaimagecatalogs/— образы ClickHouse® (backup.yaml,clickhouse.yaml,keeper.yaml) и Kafka® (kafka.yaml,strimzi.yaml). -
Сетевые ресурсы
ingressclasses/stackland-default.yaml— класс Ingress по умолчанию. -
Хранилище
persistentvolumes/,storageclasses/— постоянные тома (PV) с именами видаpvc-<UUID>.yamlи классы хранения (stackland-hdd,stackland-nvme,stackland-other,stackland-ssd). -
Пространства имен
namespaces/— YAML-описания пространств имен. -
CRD
customresourcedefinitions/— все зарегистрированные CRD в кластере. -
Дополнительные параметры компонентов
componentextraparamses/iam-main.yaml— дополнительные настройки компонента IAM. -
Вебхуки
mutatingwebhookconfigurations/,validatingwebhookconfigurations/— конфигурации MutatingWebhookConfiguration и ValidatingWebhookConfiguration.
-
-
Управление доступом
accessbindings/,rolebindings/,roles/— IAM-привязки, роли и привязки ролей уровня пространств имен. -
Сертификаты
certificates/,certificaterequests/— состояние всех TLS-сертификатов: запросы на выпуск и готовые сертификаты, сгруппированные по сервисам-заказчикам. -
Сетевые ресурсы
services/,ingresses/— конфигурация всех сервисов и Ingress-правил, сгруппированных по пространствам имен. -
Хранилище
persistentvolumeclaims/— запросы на постоянные тома (PVC), сгруппированные по пространствам имен. -
Состояние рабочих нагрузок
deployments/,daemonsets/,statefulsets/,replicasets/,pods/— конфигурация и статус всех подов, сгруппированные по пространствам имен. -
Конфигурационные файлы
configmaps/— содержимое ресурсов ConfigMap: настройки компонентов, дашборды Grafana, конфигурации операторов, сгруппированные по пространствам имен. -
Проекты и пространства имен
projectnamespaces/— связи проектов Stackland и пространств имен Kubernetes. -
Секреты
secrets/— метаданные секретов и история Helm-релизов (без содержимого секретных данных), сгруппированные по пространствам имен. -
Сервисные аккаунты
serviceaccounts/— все ресурсы ServiceAccount в кластере, сгруппированные по пространствам имен. -
OAuth-клиенты
oauthclients/— зарегистрированные OAuth-клиенты, сгруппированные по сервисам. -
Хосты
stacklandhostconfigs/— конфигурация и статус каждого узла кластера: роль, сетевые настройки, диск для установки ОС, текущая фаза. -
Логи
logs/— логи всех контейнеров во всех подах кластера. -
События
events/,Event/— события Kubernetes в YAML-формате и текстовые логи событий платформы для ключевых пространств имен.
nodes/
Диагностические данные по каждому узлу кластера. Каждый узел представлен отдельным каталогом с IP-адресом.
-
Системная информация — файлы с низкоуровневыми данными о состоянии узла:
-
controller-runtime.log— лог контроллеров Talos; -
dmesg.log— сообщения ядра Linux; -
dns-resolve-cache.log— состояние DNS-кеша; -
devices— таблица устройств; -
io— статистика ввода-вывода; -
mounts— таблица монтирования; -
processes— список процессов.
-
-
Ресурсы узла
resources/— YAML-файлы состояния и конфигурации ресурсов Talos.-
Сеть — состояние и конфигурация сетевой подсистемы: IP-адреса на интерфейсах, статусы линков (up/down, MTU, driver), маршруты, DNS-серверы и домены поиска, NTP-серверы, имя хоста (hostname) и доменное имя (domainname), MAC-адреса, статус сети. Примеры файлов:
addressstatuses.net.talos.dev.yaml,linkstatuses.net.talos.dev.yaml,routestatuses.net.talos.dev.yaml. -
Kubernetes — конфигурация и статус компонентов
control planeиkubelet: полные спецификации статических подов, статус узла, параметрыkubelet, настройки API-сервера иcontroller-manager(serviceCIDR, podCIDRs), bootstrap-манифесты и статус их применения. Примеры файлов:staticpods.kubernetes.talos.dev.yaml,staticpodstatuses.kubernetes.talos.dev.yaml,nodestatuses.kubernetes.talos.dev.yaml. -
etcd — конфигурация и состояние кластера
etcd: образ, подсети для advertise/listen, extraArgs, спецификация экземпляра (имя, адреса), ID члена кластера. Примеры файлов:etcdconfigs.etcd.talos.dev.yaml,etcdspecs.etcd.talos.dev.yaml,pkistatuses.etcd.talos.dev.yaml. -
Хранилище — состояние дисковой подсистемы и томов: блочные устройства и диски (путь, размер, UUID, символические ссылки), тома с файловыми системами, системный диск, конфигурация и статус системных томов (тип overlay/directory, parentID EPHEMERAL, selinux-метки), запросы на монтирование от сервисов (
cri,etcd,kubelet) и их статусы, жизненный цикл томов. Примеры файлов:disks.block.talos.dev.yaml,volumestatuses.block.talos.dev.yaml,mountstatuses.block.talos.dev.yaml. -
Runtime — общесистемные параметры узла: параметры ядра, статус хоста, версия Talos, загруженные модули ядра с зависимостями, статус системных сервисов, конфигурации и метаданные расширений (
yc-credential-provider,local-registry,secret-bundle), статус загрузки метаданных и так далее. Примеры файлов:kernelparamstatuses.runtime.talos.dev.yaml,machinestatuses.runtime.talos.dev.yaml,services.v1alpha1.talos.dev.yaml. -
Секреты — конфигурация PKI и секретов (содержимое скрыто): секреты
etcd, корневые и операционные секреты Kubernetes, секретыkubelet, сертификаты API и trustd, SAN для сертификатов, maintenance-секреты и сертификаты. Примеры файлов:etcdsecrets.secrets.talos.dev.yaml,kubernetesrootsecrets.secrets.talos.dev.yaml,apicertificates.secrets.talos.dev.yaml. -
Железо — информация об аппаратном обеспечении: процессоры (количество сокетов, ядер, частота, производитель), модули памяти (количество, размер, производитель), PCI-устройства, системная информация. Примеры файлов:
processors.hardware.talos.dev.yaml,memorymodules.hardware.talos.dev.yaml,systeminformations.hardware.talos.dev.yaml. -
Производительность — статистика использования ресурсов: загрузка CPU по ядрам, детальная статистика памяти. Примеры файлов:
cpustats.perf.talos.dev.yaml,memorystats.perf.talos.dev.yaml. -
Служебные — метаресурсы Talos: пространства имен с описаниями, определения типов ресурсов с алиасами, информация о кластере, идентичность узла, SBOM-компоненты с версиями и лицензиями. Примеры файлов:
namespaces.meta.cosi.dev.yaml,resourcedefinitions.meta.cosi.dev.yaml,infos.cluster.talos.dev.yaml.
-
-
Логи сервисов узла
service-logs/— логи и статусы системных сервисов Talos.-
.log— лог работы сервиса; -
.state— текущее состояние сервиса.
-
-
Логи
control planekubernetes-logs/kube-system/— логи системных подов Kubernetes, работающих на этом узле.
cluster/
Конфигурационные файлы кластера Stackland и логи его установки.
-
Конфигурация кластера
config/— основные конфигурационные файлы:-
cluster.yaml— общая конфигурация кластера; -
hosts.yaml— конфигурация каждого хоста кластера.
-
-
Диагностический лог
diagnostics.log— лог процесса сбора диагностической информации. -
Логи установки
install/— лог процесса инсталляции.
Сценарии использования архива диагностики
Проверка успешности установки
Откройте cluster/platformconfigs/main.yaml и убедитесь, что status.initialInstall.state: Installed. Если состояние отличается, эти действия помогут найти причину:
-
Проверьте логи инсталлятора в
cluster/install/install-*.logна общий ход установки и возможные ошибки на разных этапах. -
Проверьте статус всех компонентов. Если какие-то компоненты не в статусе
Ready, перейдите к сценарию «Диагностика компонента». -
Откройте
cluster/nodes/и убедитесь, что все узлы находятся в статусеReady. Если узел в другом статусе, перейдите к сценарию «Диагностика проблем с узлом». -
Проверьте логи системных сервисов на узлах в
nodes/<IP>/service-logs/. При проблемах установки в первую очередь смотритеetcd.log,kubelet.log. -
Откройте
nodes/<IP>/resources/machinestatuses.runtime.talos.dev.yamlи убедитесь, чтоstage: runningиready: true.
Диагностика компонента
Найдите интересующий вас компонент в cluster/componentinstallations/<имя_компонента>-main.yaml и проверьте этап (phase). Если после завершения инсталляции компонента статус отличается от Ready, эти действия помогут найти причину:
-
Проверьте поле
messageресурсаcluster/componentinstallations/<имя_компонента>-main.yamlна наличие ошибок. -
Найдите соответствующую конфигурацию в
cluster/<имя_компонента>configs/main.yaml. Убедитесь в корректности параметров, если компонент конфигурировался. -
Найдите логи подов компонентов в
logs/<пространство_имен>/<имя-пода>/и проверьте их на наличие ошибок. -
Проверьте события в
events/для пространства имен компонента на наличие ошибок. По событиям удобно определить последовательность сбоя.
Диагностика проблем с узлом
-
Откройте
nodes/<IP>/resources/services.v1alpha1.talos.dev.yamlи проверьте статус системных сервисов:running,healthy. Сервисы сhealthy: falseтребуют внимания в первую очередь. -
Найдите логи проблемного сервиса в
nodes/<IP>/service-logs/<сервис>.logи проверьте их на наличие ошибок. Файл<сервис>.stateсодержит текущее состояние сервиса. -
При подозрении на аппаратные или общесистемные проблемы откройте
nodes/<IP>/dmesg.log. Этот лог содержит сообщения ядра Linux с момента загрузки узла и полезен для диагностики: OOM и завершения процессов, ошибок ввода-вывода на дисках, проблем с сетевыми драйверами, падения оборудования, ошибок файловых систем, проблем с загрузкой модулей ядра. -
Проверьте
nodes/<IP>/processesна наличие зависших или потребляющих аномальное количество ресурсов процессов.
Диагностика проблем с control plane
Откройте nodes/<IP>/kubernetes-logs/kube-system/ на всех мастер-узлах и проверьте логи kube-apiserver, kube-controller-manager, kube-scheduler. Наличие файлов *-exited.log указывает на аварийное завершение компонента. Далее:
-
Откройте
nodes/<IP>/resources/staticpodstatuses.kubernetes.talos.dev.yamlи проверьте статус статических подов:restartCount,stateконтейнеров. -
Если
kube-apiserverне стартует, проверьтеnodes/<IP>/resources/etcdmembers.etcd.talos.dev.yamlиpkistatuses.etcd.talos.dev.yaml— статусetcdи его PKI. -
Для комплексного анализа откройте
logs/kube-system/вk8s/— там собраны логи подовcontrol planeсо всех узлов. -
Проверьте
nodes/<IP>/service-logs/etcd.logна наличие ошибок кворума или проблем с дискомetcd.
Мониторинг и логирование для диагностики
Помимо sladm diag, для диагностики можно использовать встроенные средства мониторинга и логирования.
kubectl
Для просмотра логов в реальном времени можно использовать стандартные команды Kubernetes:
# Логи конкретного пода
kubectl logs -n <пространство_имен> <имя-пода>

# Логи всех подов с меткой app=console
kubectl logs -n stackland-console -l app.kubernetes.io/name=stackland-console
Grafana Loki
Для просмотра логов можно также воспользоваться встроенной системой логирования на базе Grafana Loki. Для этого:
-
Откройте веб-интерфейс Grafana по адресу
https://grafana.sys.<домен_кластера>. -
В боковом меню выберите Explore.
-
В выпадающем списке источника данных выберите Loki.
-
В поле запроса настройте фильтры для получения нужных логов: укажите пространство имен, имя пода, уровень логирования и другие параметры.
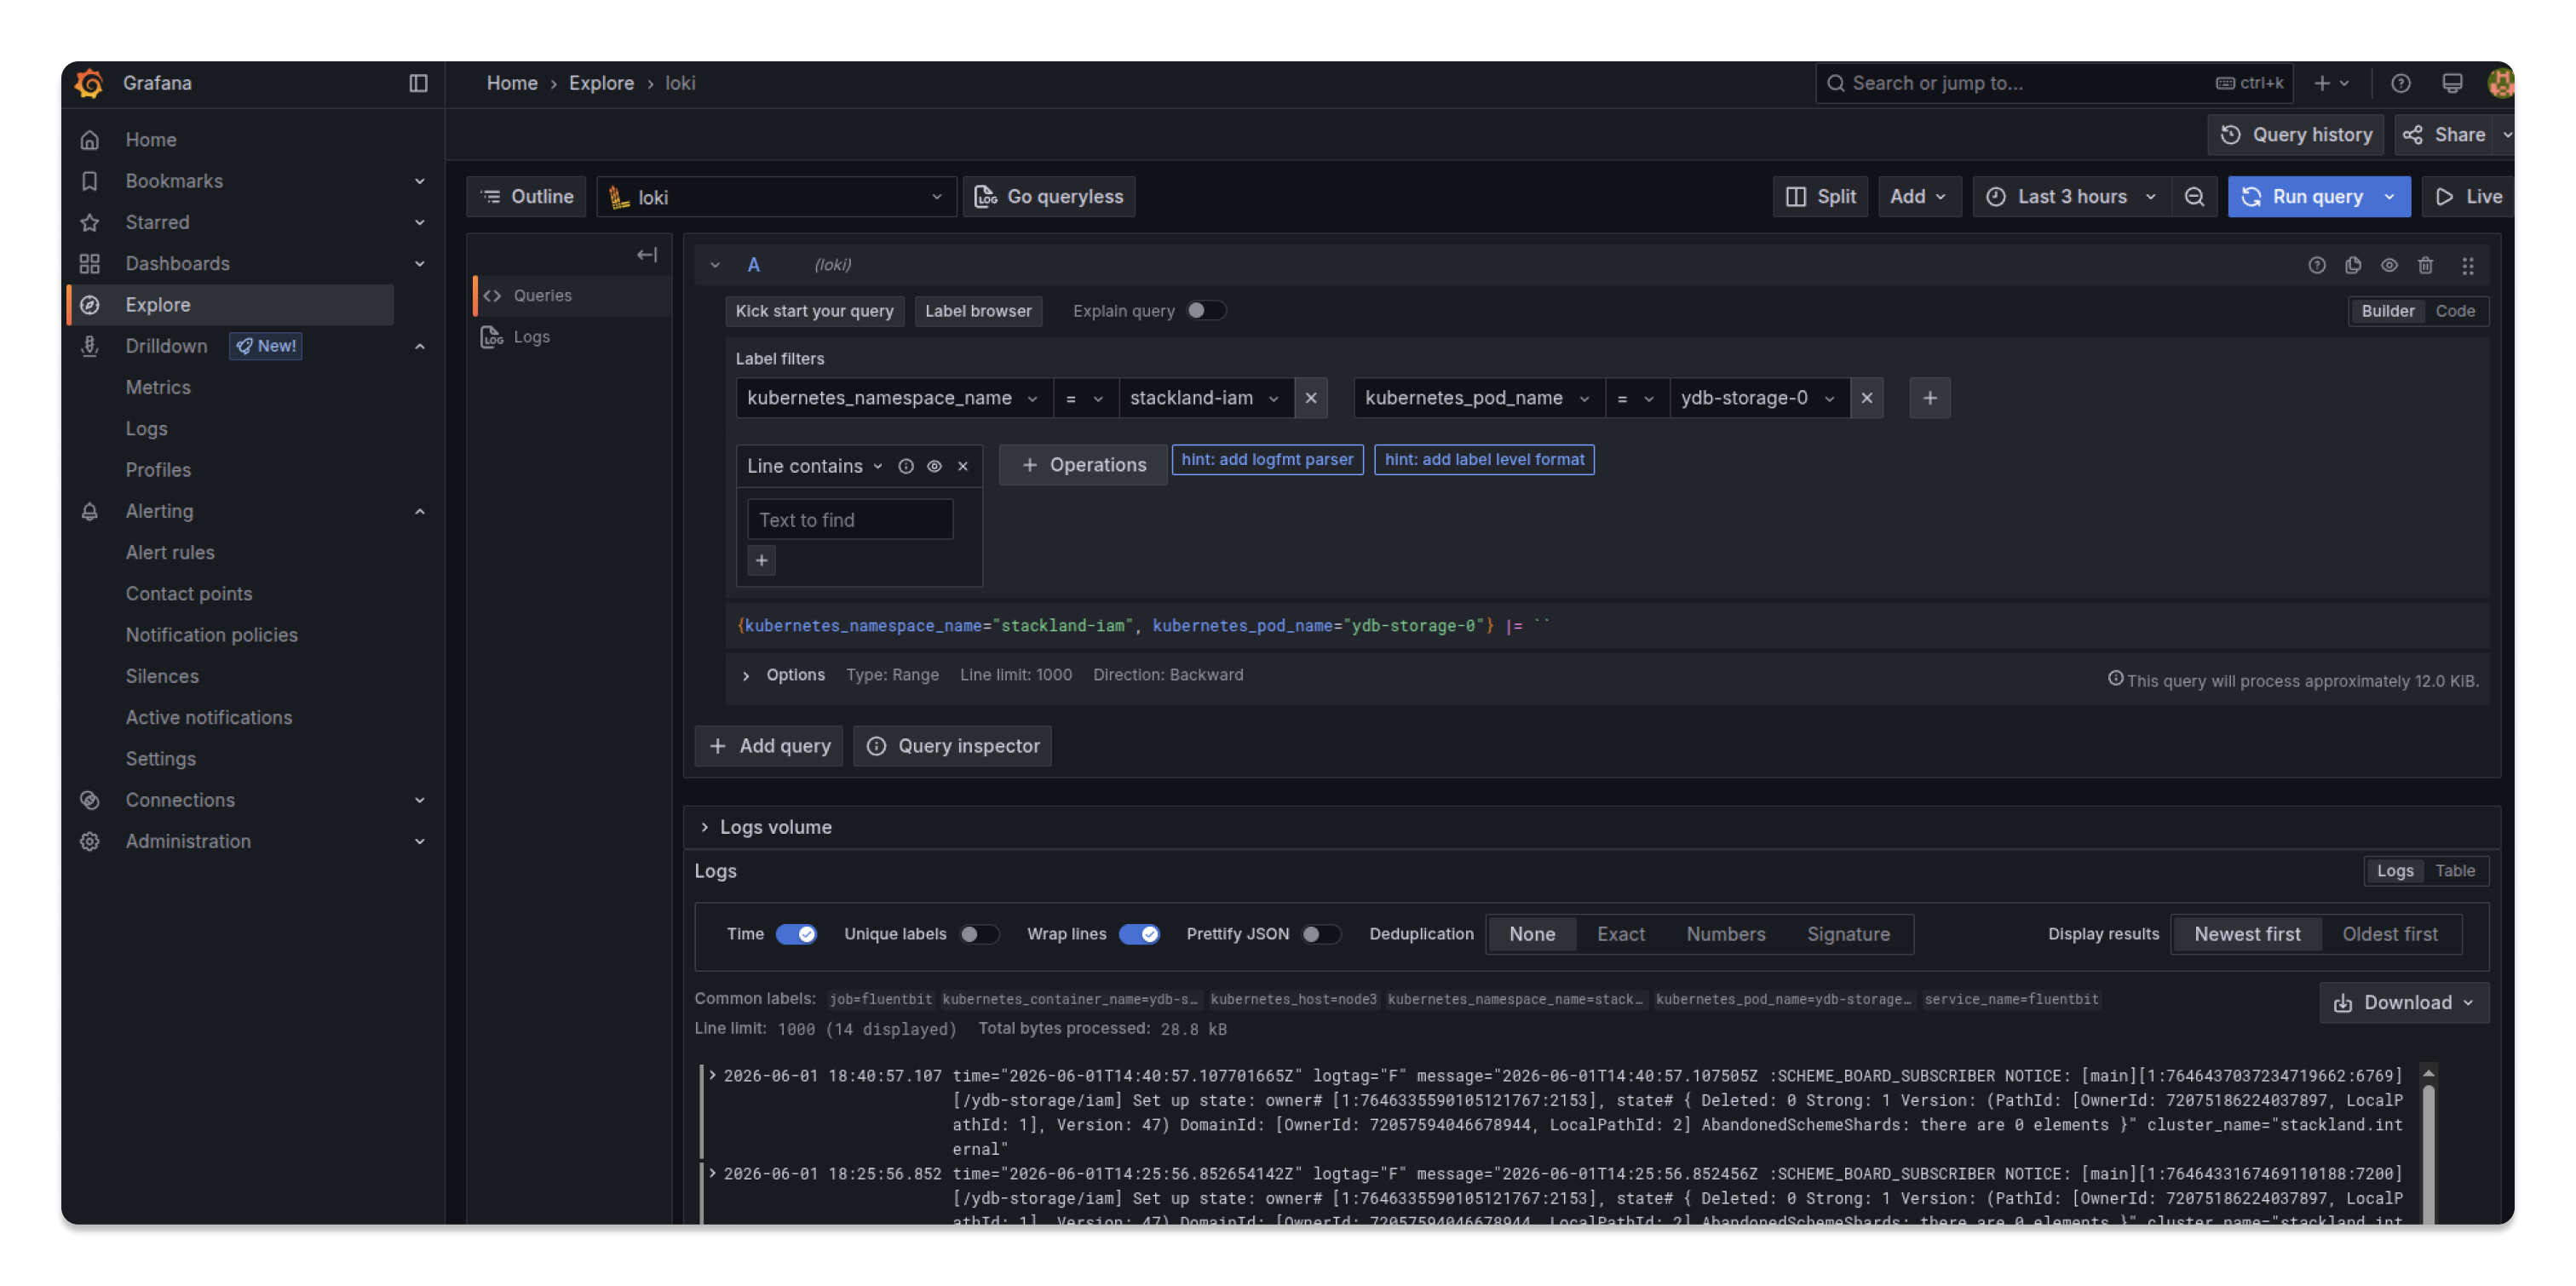
Логи всех подов кластера автоматически собираются агентом Fluent Bit и отправляются в Loki, поэтому они доступны для поиска и анализа сразу после установки платформы.
Метрики и дашборды
При диагностике неисправностей полезно совместно с логами использовать метрики и встроенные дашборды. Grafana предоставляет набор готовых дашбордов для мониторинга состояния кластера и компонентов. Все дашборды доступны в разделе Dashboards веб-интерфейса Grafana.
Важно
Данные для входа в Grafana находятся в секрете grafana-admin-credentials, в пространстве имен stackland-monitoring.
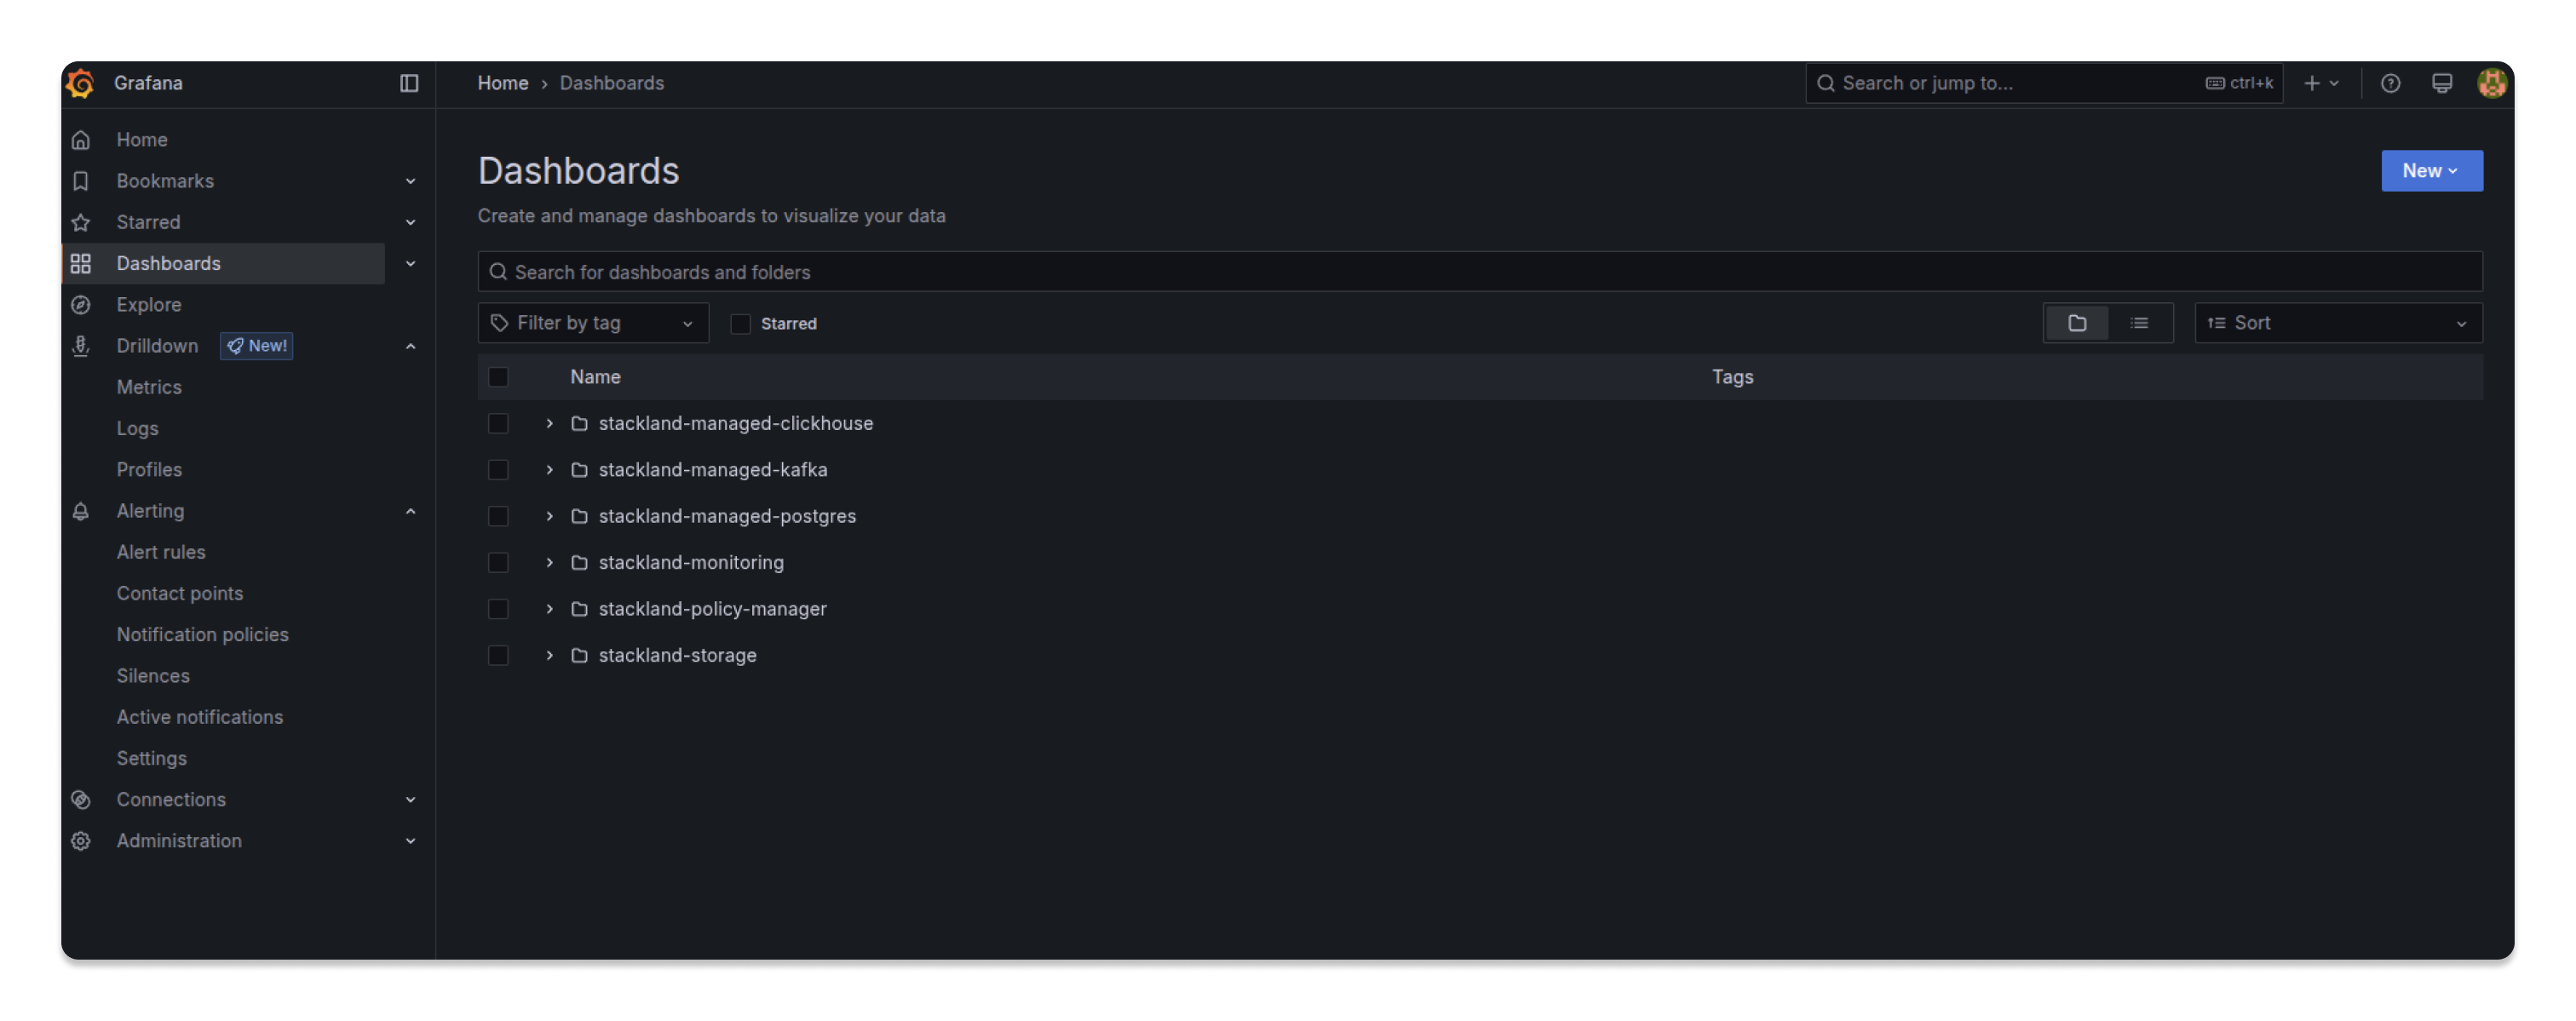
Grafana Alerts
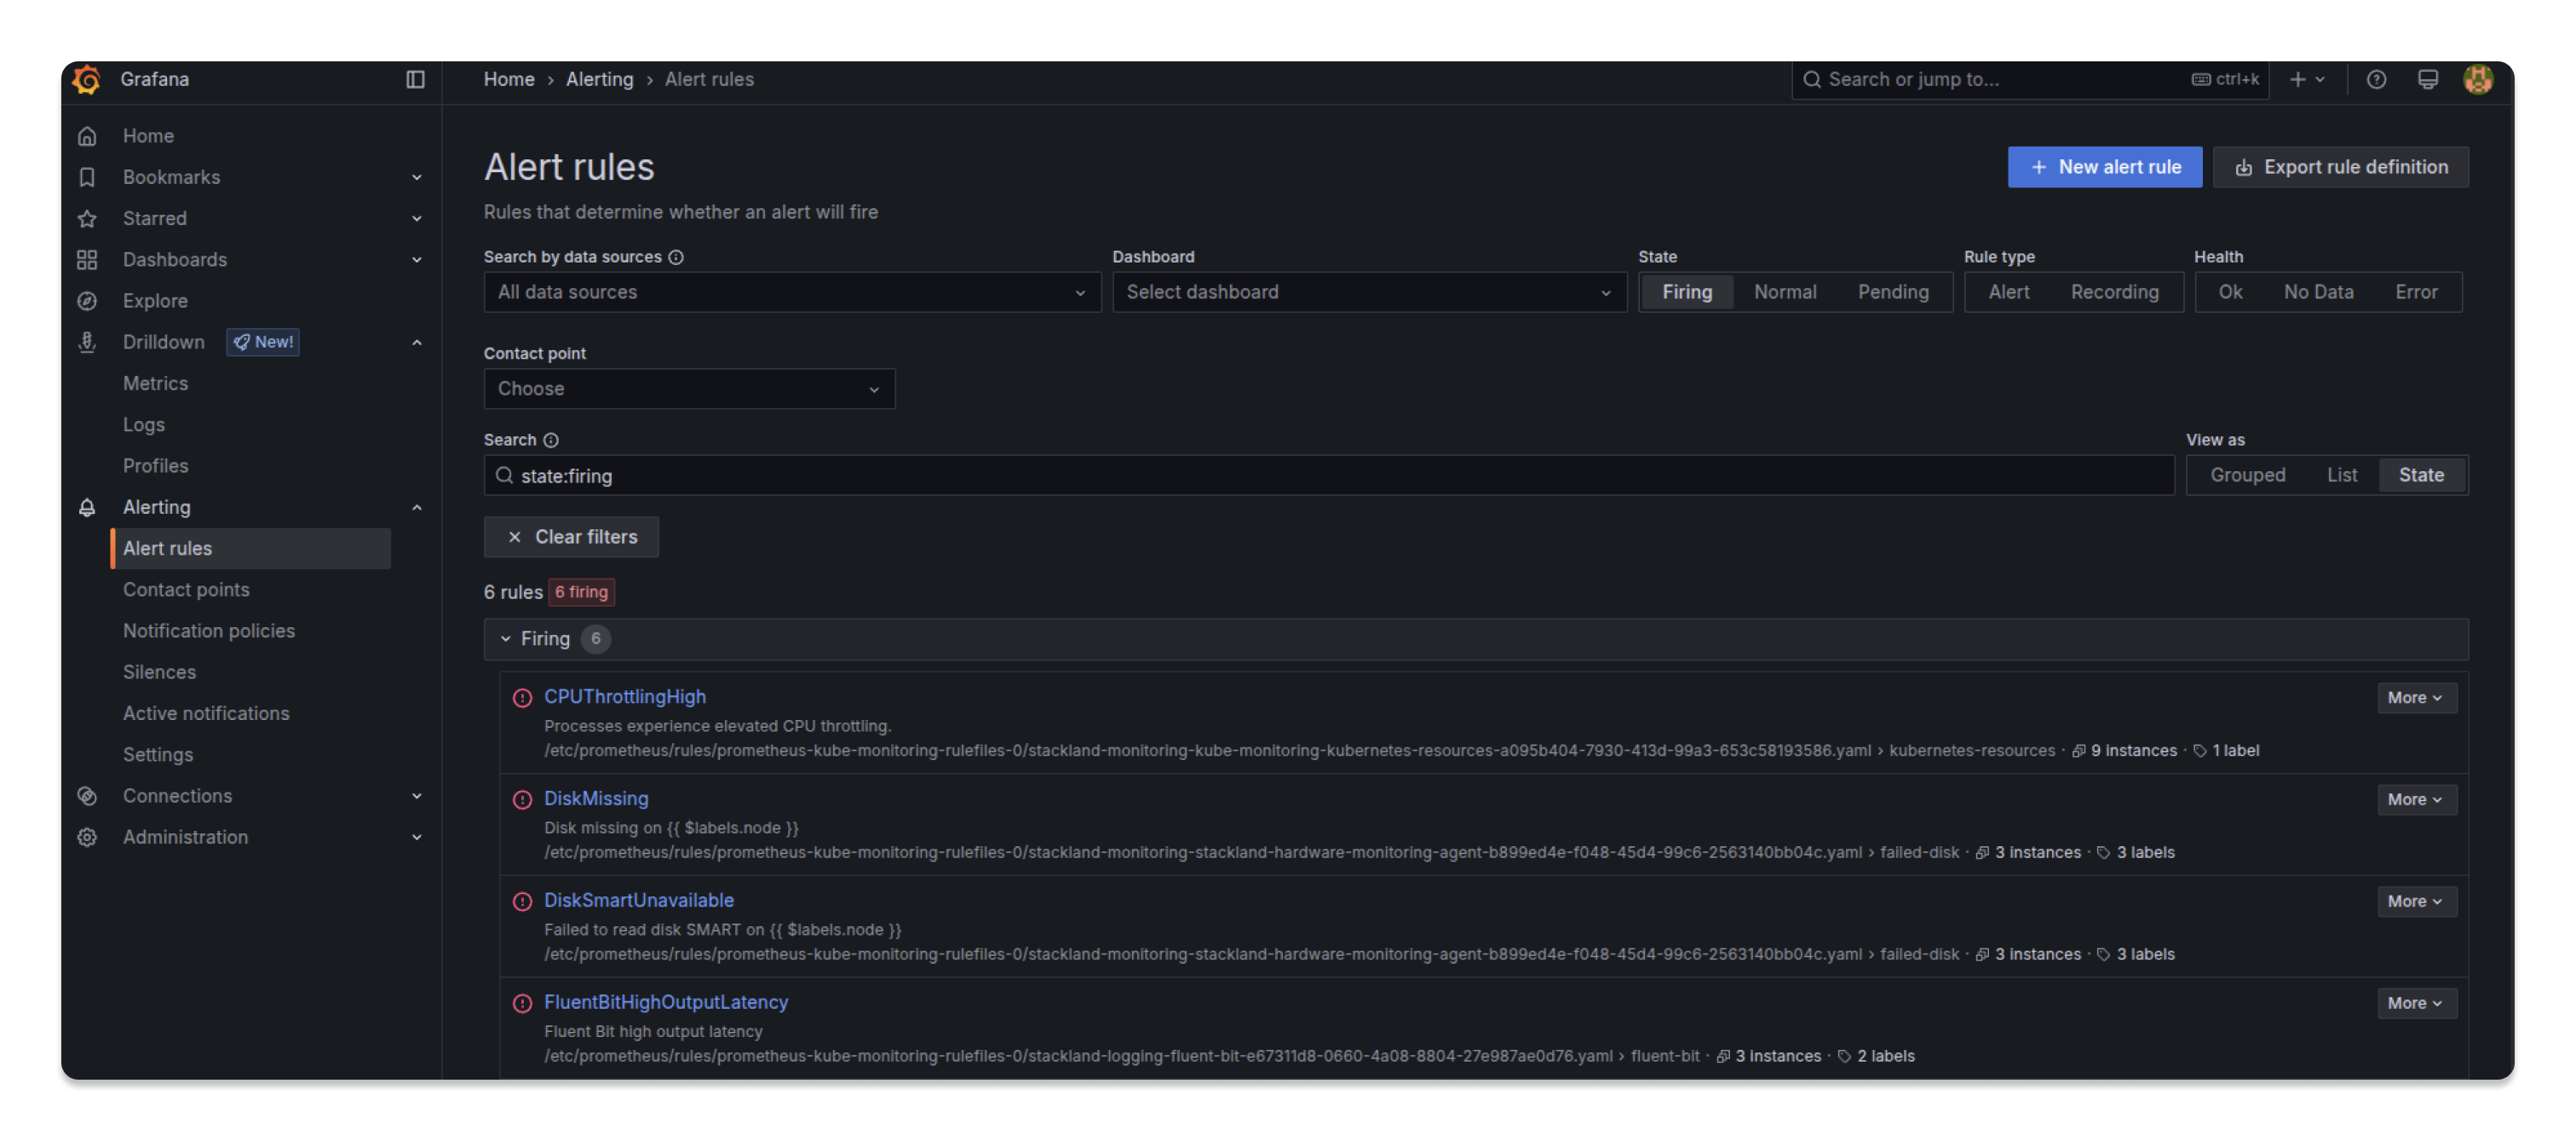
Встроенный набор алертов поможет выявить проблемы в работе платформы и укажет на возможный источник проблемы. Все алерты можно посмотреть в веб-интерфейсе Grafana, в разделе Alerting.
-
Какие компоненты и ситуации покрывают алерты
-
Поды и рабочие нагрузки — CrashLooping, длительное ожидание запуска, OOMKilled, эвикция подов, расхождение реплик в Deployment, StatefulSet или DaemonSet, зависшие развертывания.
-
Узлы кластера — недоступность узла, заполнение файловой системы и inodes, высокая утилизация CPU, saturation системы, сетевые ошибки, проблемы с файловыми дескрипторами, degraded RAID, отказ дисков, рассинхронизация часов.
-
etcd — отсутствие членов кластера, потеря лидера, высокая частота смены лидера, ошибки gRPC, медленные запросы, высокая длительность
fsyncиcommit, заполнение базы данных, фрагментация. -
Kubernetes API — недоступность API-сервера, высокая латентность запросов, ошибки аутентификации, истечение клиентских сертификатов, ошибки агрегированных API.
-
Мониторинг — недоступность Prometheus, ошибки конфигурации, проблемы с отправкой алертов в Alertmanager, высокая нагрузка запросов, отставание remote write.
-
Логирование — недоступность Fluent Bit, высокая частота ошибок вывода, потеря записей, переполнение хранилища, ошибки запросов Loki, высокая латентность Loki.
-
Хранилище — заполнение PersistentVolume, недостаток места в VolumeGroup, недоступность TopoLVM или TopoVGM, состояние томов degraded.
-
Сертификаты — истечение сертификатов cert-manager, недоступность cert-manager.
-
Квоты и ресурсы — превышение квот пространств имен, перерасход CPU и памяти, высокий CPU throttling.
-
Итоги
Вы узнали, как проводить диагностику кластера Stackland. Вот что важно запомнить:
-
Команда
sladm diagсоздает полный снимок состояния кластера (логи, конфиги, события), который можно использовать как для самостоятельной диагностики, так и для обращения в техническую поддержку. -
Структура архива позволяет быстро локализовать проблему:
cluster/содержит конфигурацию и логи установки для проверки успешности развертывания,k8s/— полное состояние объектов Kubernetes и платформы для диагностики компонентов, рабочих нагрузок и прав доступа,nodes/— низкоуровневое состояние каждого узла Talos для диагностики системных сервисов, сети, хранилища,etcdи аппаратных проблем. -
Используйте Grafana Loki и встроенные дашборды для мониторинга метрик в реальном времени, чтобы выявлять проблемы до их критического развития. Алертинг можно настроить с помощью Grafana Alerts.