Обновление кластера

В этом рецепте вы узнаете, как устроен процесс обновления Stackland, какие риски с ним связаны и как подготовиться к обновлению кластера. Также вы выясните, как запускать процесс обновления и отслеживать его состояние.
Как работает обновление Stackland
Понимание архитектуры обновления помогает правильно подготовить кластер к этой процедуре и решить проблемы, которые могут возникнуть в процессе обновления.
Обзор процесса
Обновление Stackland — это идемпотентная процедура приведения кластера к целевому состоянию, описанному в установочных конфигурациях. Процесс обновления охватывает три уровня:
-
операционную систему (Talos);
-
системные образы (
kubelet,etcd, Cilium); -
платформенные компоненты (IAM, Monitoring, Object Storage и другие).
Ключевые принципы
-
Идемпотентность. Запуск
sladmидемпотентен. При прерывании процесса (например, при перезапуске пода на другом узле)sladmзаново проверяет состояние узлов и возобновляет работу с момента остановки. Уже обновленные узлы пропускаются. -
Последовательное обновление. Узлы обновляются по одному, что обеспечивает доступность stateful-сервисов во время обновления.
-
Порядок обновления узлов. Узлы
control-planeобновляются передworker-узлами. -
Возможность отката. При неудачном обновлении откат к предшествующему состоянию выполняется автоматически.
Важно
Запуск отката вручную не поддерживается.
Итак, утилита sladm сравнивает фактическое состояние кластера с желаемым, вычисляет разницу и применяет изменения в правильном порядке, обеспечивая отказоустойчивость и возможность возобновления работы после прерывания.
Процесс обновления
Обновление можно разделить на пять ключевых этапов.
Этап 1. Запуск обновления и валидация конфигурации
-
Задание
sladmначинает работу в пространстве именstackland-install. -
Монтируется конфигурация кластера:
-
ConfigMap:
stackland-cluster-config(cluster.yaml),stackland-hosts-list(hosts.yaml); -
Secret:
stackland-secrets-config(secrets.yaml).
-
-
Конфигурационные файлы валидируются.
Этап 2. Загрузка образов
-
Утилита
sladmзагружает образы для релиза изcr.yandex. -
Утилита
sladmформирует OCI-бандл.
Этап 3. Последовательное обновление узлов
-
Узлы обновляются строго по одному, в первую очередь —
control-plane. -
Для каждого узла:
-
sladmподключается к Talos API узла. -
sladmзагружает образы в локальный registry узла (<hostname>:5001). -
sladmзапускаетkubelet. -
sladmпроверяет версию Talos и список расширений. -
Если установленная версия Talos не совпадает с целевой,
sladmзапускает обновление Talos черезstackland-installer. -
После обновления Talos узел перезагружается.
-
После загрузки настраиваются системные компоненты (
kubelet,etcdи другие). -
При изменении в системных компонентах узел перезагружается.
-
После всех перезагрузок узел переходит в статус
Configuring.
-
Этап 4. Завершение работы sladm
-
Задание
sladmожидает перехода всех узлов в статусReady. -
Задание
sladmзавершается.
Важно
Обновление платформенных компонентов продолжается асинхронно.
Этап 5. Обновление платформенных компонентов
-
Component Manager получает управление, когда инфраструктура готова.
-
Component Manager вычисляет разницу между текущим и целевым состоянием для каждого компонента.
-
Component Manager применяет изменения в следующем порядке:
-
Add — установка новых компонентов;
-
Edit — обновление существующих;
-
Delete — удаление компонентов, которых нет в целевом манифесте.
Каждый компонент обновляется с учетом зависимостей. Например, IAM зависит от
certificate-managerиvolumes. -
-
Component Manager отмечает статус обновления в ресурсе
ComponentInstallation.
Рекомендации перед обновлением
Как и при других критических операциях, перед обновлением платформы следует провести ряд действий и проверок. Мы разделили рекомендации на несколько блоков:
-
Stackland и его компоненты
-
Пользовательские нагрузки
-
Управляемые сервисы
Stackland и его компоненты
Убедитесь, что платформа готова к обновлению. Для этого следуйте рекомендациям:
-
Проверка релизного канала
Релизный канал определяет, какие версии Stackland доступны для обновления — стабильные релизы (Stable) либо релизы для тестирования новых функций (Alpha). По умолчанию используется канал Stable.
Для проверки релизного канала выполните команду:
kubectl describe platformconfig main | grep 'Release Channel'Release Channel: Stable -
Ознакомление с Release Notes целевой версии
Перед любым обновлением обязательно изучите Release Notes версии, на которую планируете перейти. В новой версии могут содержаться изменения, требующие дополнительных действий.
-
Проверка состояния кластера
Команда
talosctl healthвыполняет комплексную проверку состояния кластера. Подробнее — в инструкции «Базовое использование talosctl».Все проверки должны завершиться успешно:
# Необходимо указать IP-адрес любого узла control-plane
talosctl --nodes 172.19.11.136 health
discovered nodes: ["172.19.11.136" "172.19.11.137" "172.19.11.138"] waiting for etcd to be healthy: ... waiting for etcd to be healthy: OK waiting for etcd members to be consistent across nodes: ... waiting for etcd members to be consistent across nodes: OK waiting for etcd members to be control plane nodes: ... waiting for etcd members to be control plane nodes: OK waiting for apid to be ready: ... waiting for apid to be ready: OK ... -
Проверка статусов платформенных компонентов
Все компоненты должны быть в статусе
Ready.kubectl get componentinstallationsNAME PHASE VERSION MESSAGE AGE certificate-manager-main Ready 26.2.1 Component is in the target state 2d17h console-main Ready 26.2.1 Component is in the target state 2d16h dns-main Ready 26.2.1 Component is in the target state 2d17h -
Проверка доступных ресурсов
-
Свободное место на дисках. Убедитесь, что на узлах достаточно свободного места, так как во время обновления на них будут загружаться новые образы контейнеров.
# Вывод в GiB с фильтрацией
kubectl get volumegroups -n stackland-volumes -o json | jq '.items[] | select(.status.free != null) | {name: .metadata.name, free_bytes: .status.free, free_gib: (.status.free | tonumber / 1073741824)}'
... { "name": "vg-other-node2", "free_bytes": "256750125056", "free_gib": 239.1171875 } ...# Вывод в Bytes kubectl -n stackland-volumes get volumegroups -o custom-columns='NAME:.metadata.name,FREE:.status.free'NAME FREE ... vg-nvme-node2 <none> vg-nvme-node3 <none> vg-other-node1 213800452096 vg-other-node2 256750125056 vg-other-node3 256750125056 ... -
Память и CPU. Проверьте, что есть запас памяти и CPU, так как в процессе обновления рабочие нагрузки будут переезжать с обновляемого узла на другие.
Проверить утилизацию ресурсов можно через встроенные дашборды Grafana — например, через дашборд
Node Exporter Full. Выполняйте проверку для каждого узла.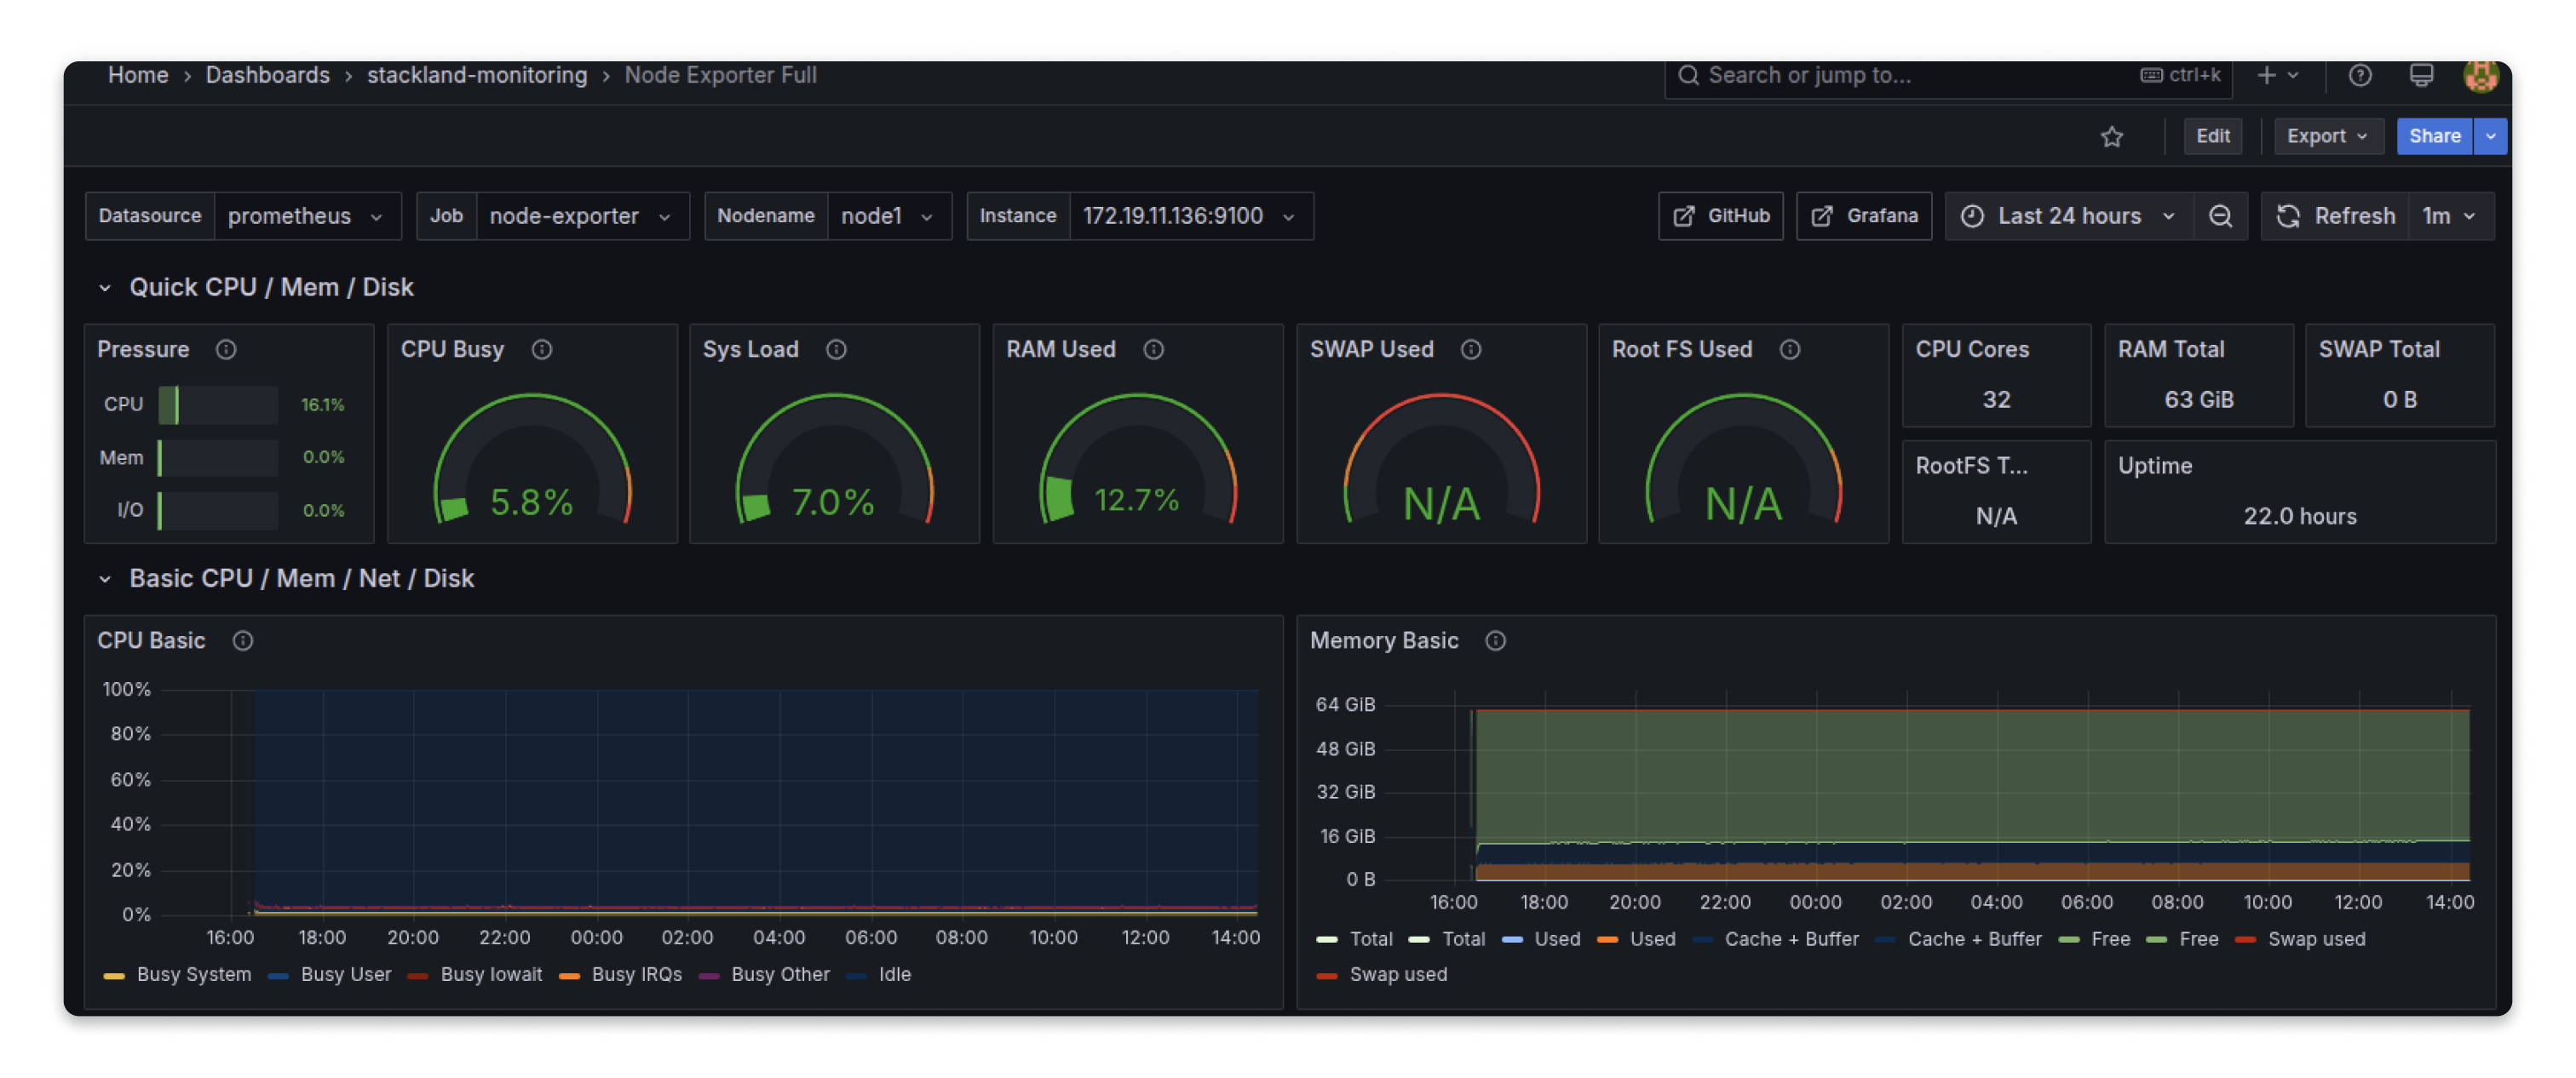
Другой способ проверки — через
kubectl:kubectl top nodesNAME CPU(cores) CPU% MEMORY(bytes) MEMORY% node1 1826m 5% 11248Mi 17% node2 2436m 7% 11569Mi 18% node3 2529m 7% 11090Mi 17%
-
-
Создание резервной копии
etcdСоздайте снапшот
etcdна любомcontrol-plane-узле. Это позволит восстановить кластер в случае серьезного сбоя:# Необходимо указать IP-адрес любого узла control-plane talosctl etcd snapshot ./etcd-pre-upgrade-$(date +%Y%m%d-%H%M%S).snapshot -n 172.19.11.136etcd snapshot saved to "./etcd-pre-upgrade-20260702-101107.snapshot" (458379296 bytes) snapshot info: hash c578568b, revision 53621386, total keys 4408, total size 458379264 -
Создание диагностического архива
Диагностический архив содержит информацию о состоянии кластера и все манифесты. Эта информация может помочь, если возникнут проблемы в процессе или после обновления.
sladm diag --artifacts-dir ./pre-upgrade-backup
Пользовательские нагрузки
Этот блок рекомендаций посвящен пользовательским приложениям, развернутым в кластере.
-
Проверка на устаревшие Kubernetes API
Одна из самых частых причин отказов при обновлении — использование версий API, удаленных в новом релизе Kubernetes. Заранее проверьте манифесты и существующие ресурсы в кластере.
Совет
Можно воспользоваться утилитой
plutoдля поиска проблемных объектов.Все проблемные объекты необходимо обновить до актуальных API до начала обновления кластера.
-
Проверка состояния подов
Убедитесь, что все пользовательские поды находятся в стабильном состоянии.
-
Проверка наличия
PodDisruptionBudget(PDB)При обновлении узлы будут поочередно изолироваться (
drain) для эвакуации подов. Если у приложения всего одна реплика или нет PDB, возможна кратковременная недоступность. Проверьте, что для критичных сервисов настроеныPodDisruptionBudget. -
Ручное резервное копирование данных приложений
Несмотря на то что обновление не затрагивает Persistent Volume напрямую, рекомендуем инициировать внеплановое резервное копирование для всех критически важных данных.
Управляемые сервисы
Если в кластере работают управляемые сервисы, например PostgreSQL, ClickHouse®, Kafka®, перед обновлением Stackland рекомендуются дополнительные проверки и действия, связанные со спецификой конкретного ПО.
Рассмотрите для примера кластер PostgreSQL, развернутый с тремя узлами и конфигурацией по умолчанию в пространстве имен team-alpha-dev. Риски при обновлении такого кластера собрали в таблице:
|
Риск |
Описание |
|
Потеря подключения к БД |
Во время обновления узлов поды PostgreSQL могут перезапускаться, что приведет к кратковременной недоступности БД |
|
Проблемы с резервным копированием |
Во время обновления могут временно не создаваться резервные копии в S3 |
|
Снижение производительности |
При обновлении узлов кластер работает с уменьшенным количеством реплик (две из трех), что может повлиять на производительность при высокой нагрузке |
|
Потеря данных в случае сбоя |
Если обновление прервется на этапе переключения реплик и кластер потеряет кворум, может произойти рассинхронизация WAL-позиций между репликами. Это может привести к безвозвратной потере уже подтвержденных транзакций |
|
Проблемы с WAL-архивацией |
Во время перезагрузки узлов может временно прерваться архивирование WAL в S3 |
Рекомендации
-
Проверка состояния кластера. Все узлы должны быть в статусе
Ready.kubectl get postgresqlclusters -n team-alpha-devNAME AGE INSTANCES READY STATUS PRIMARY VERSION postgresql-cluster-ug91 3d 3 3 running postgresql-cluster-ug91-2 -
Создание резервной копии вручную на случай сбоя. Процесс описан в инструкции «Создать резервную копию».
Важно
Обязательно убедитесь, что процесс создания резервной копии завершился успешно, и проверьте наличие копии в S3-бакете.
Запуск обновления
Далее опишем процесс обновления до версии 26.2.2 для кластера с доступом в интернет.
Примечание
Подробнее о процессе обновления, в том числе в изолированной среде, вы можете прочитать в статье Обновить кластер.
-
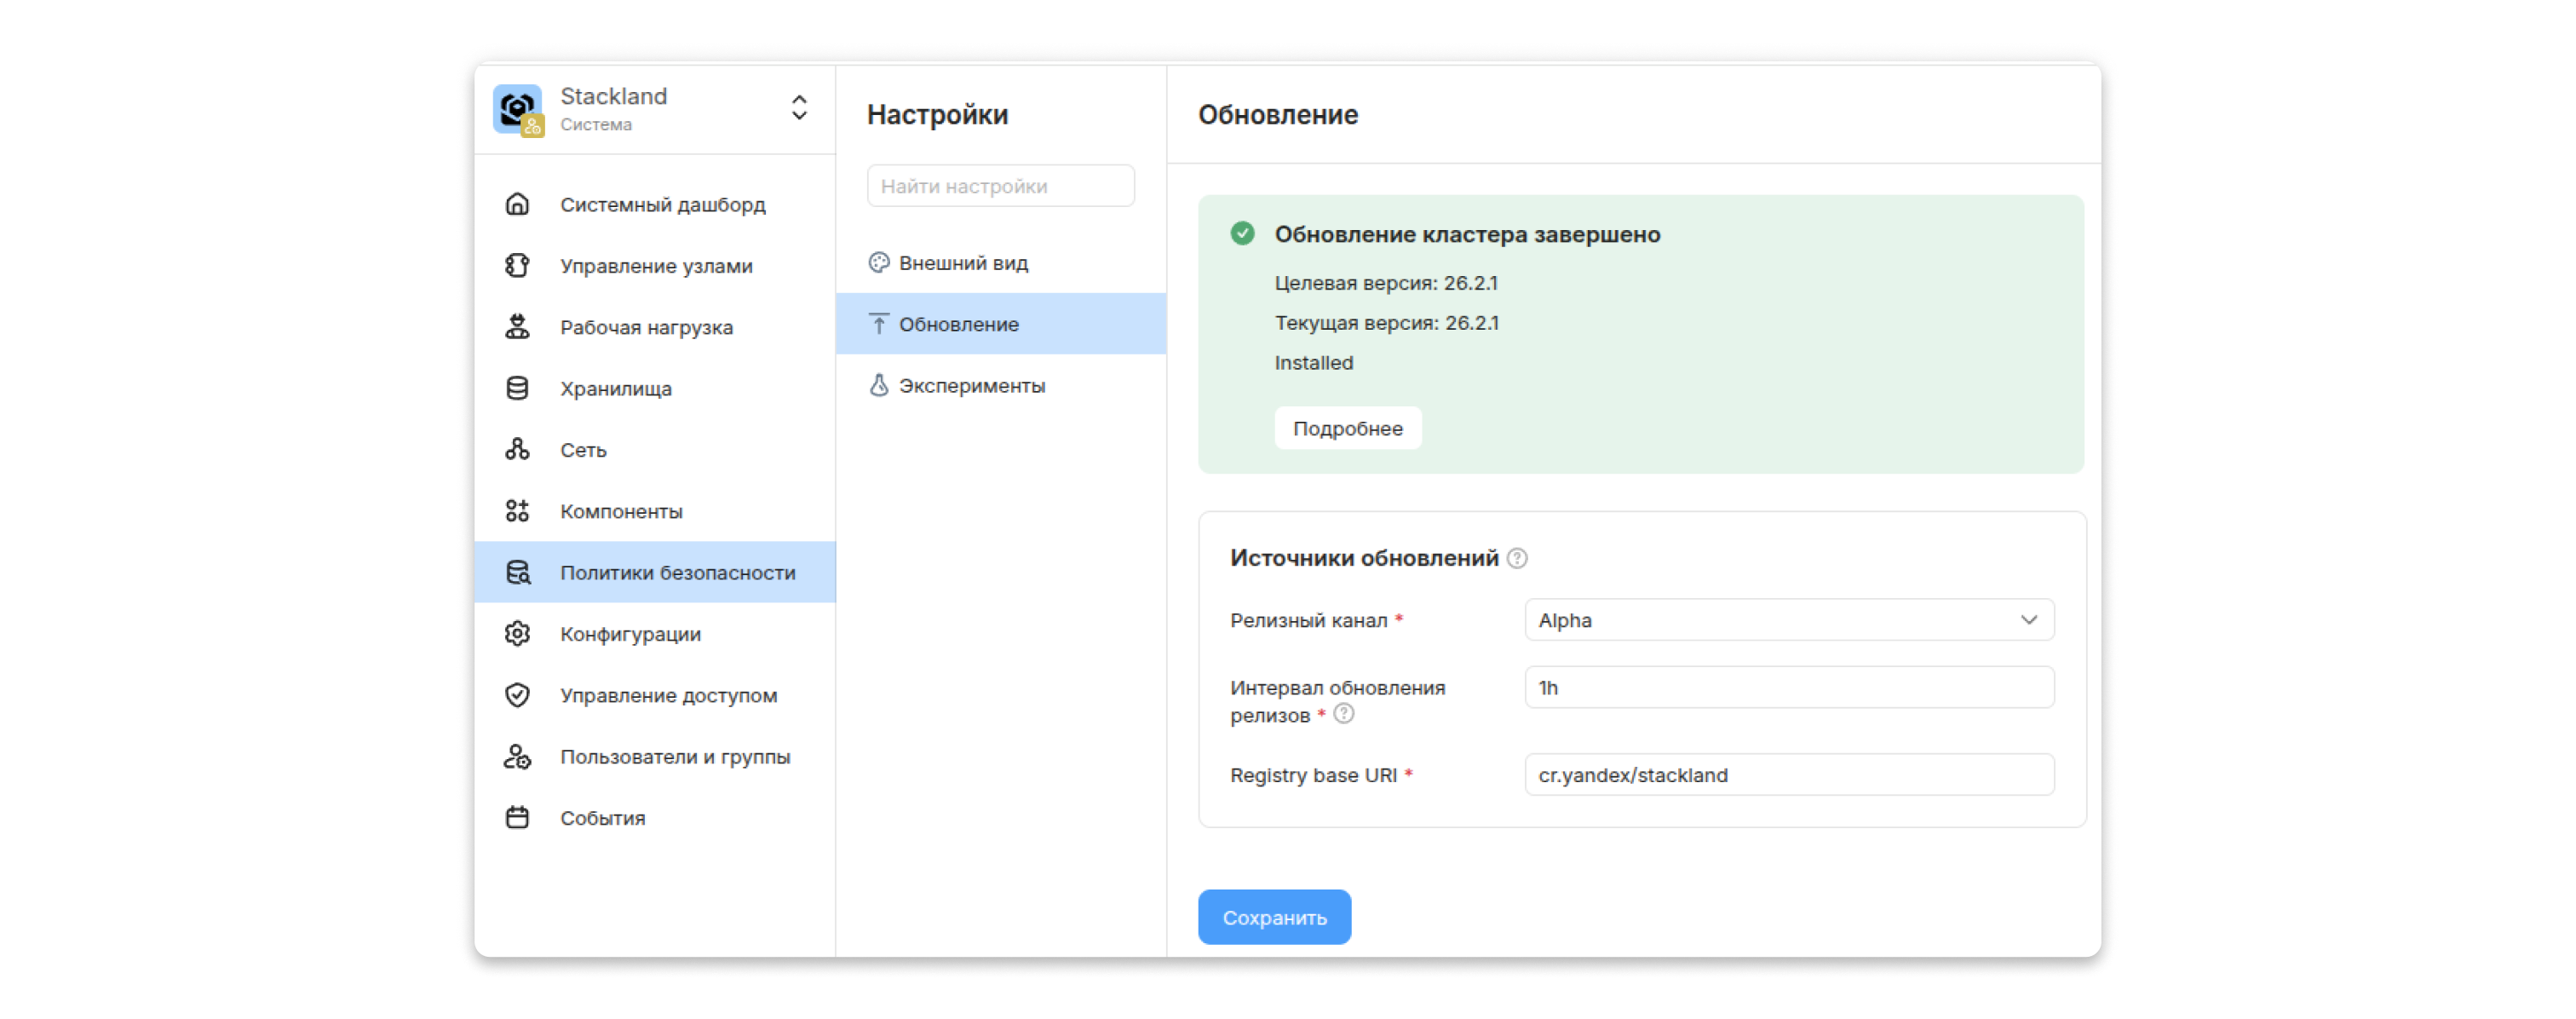
В меню слева выберите Настройки.
-
В подменю выберите Обновление.
-
Измените релизный канал на Alpha и нажмите Сохранить.
-
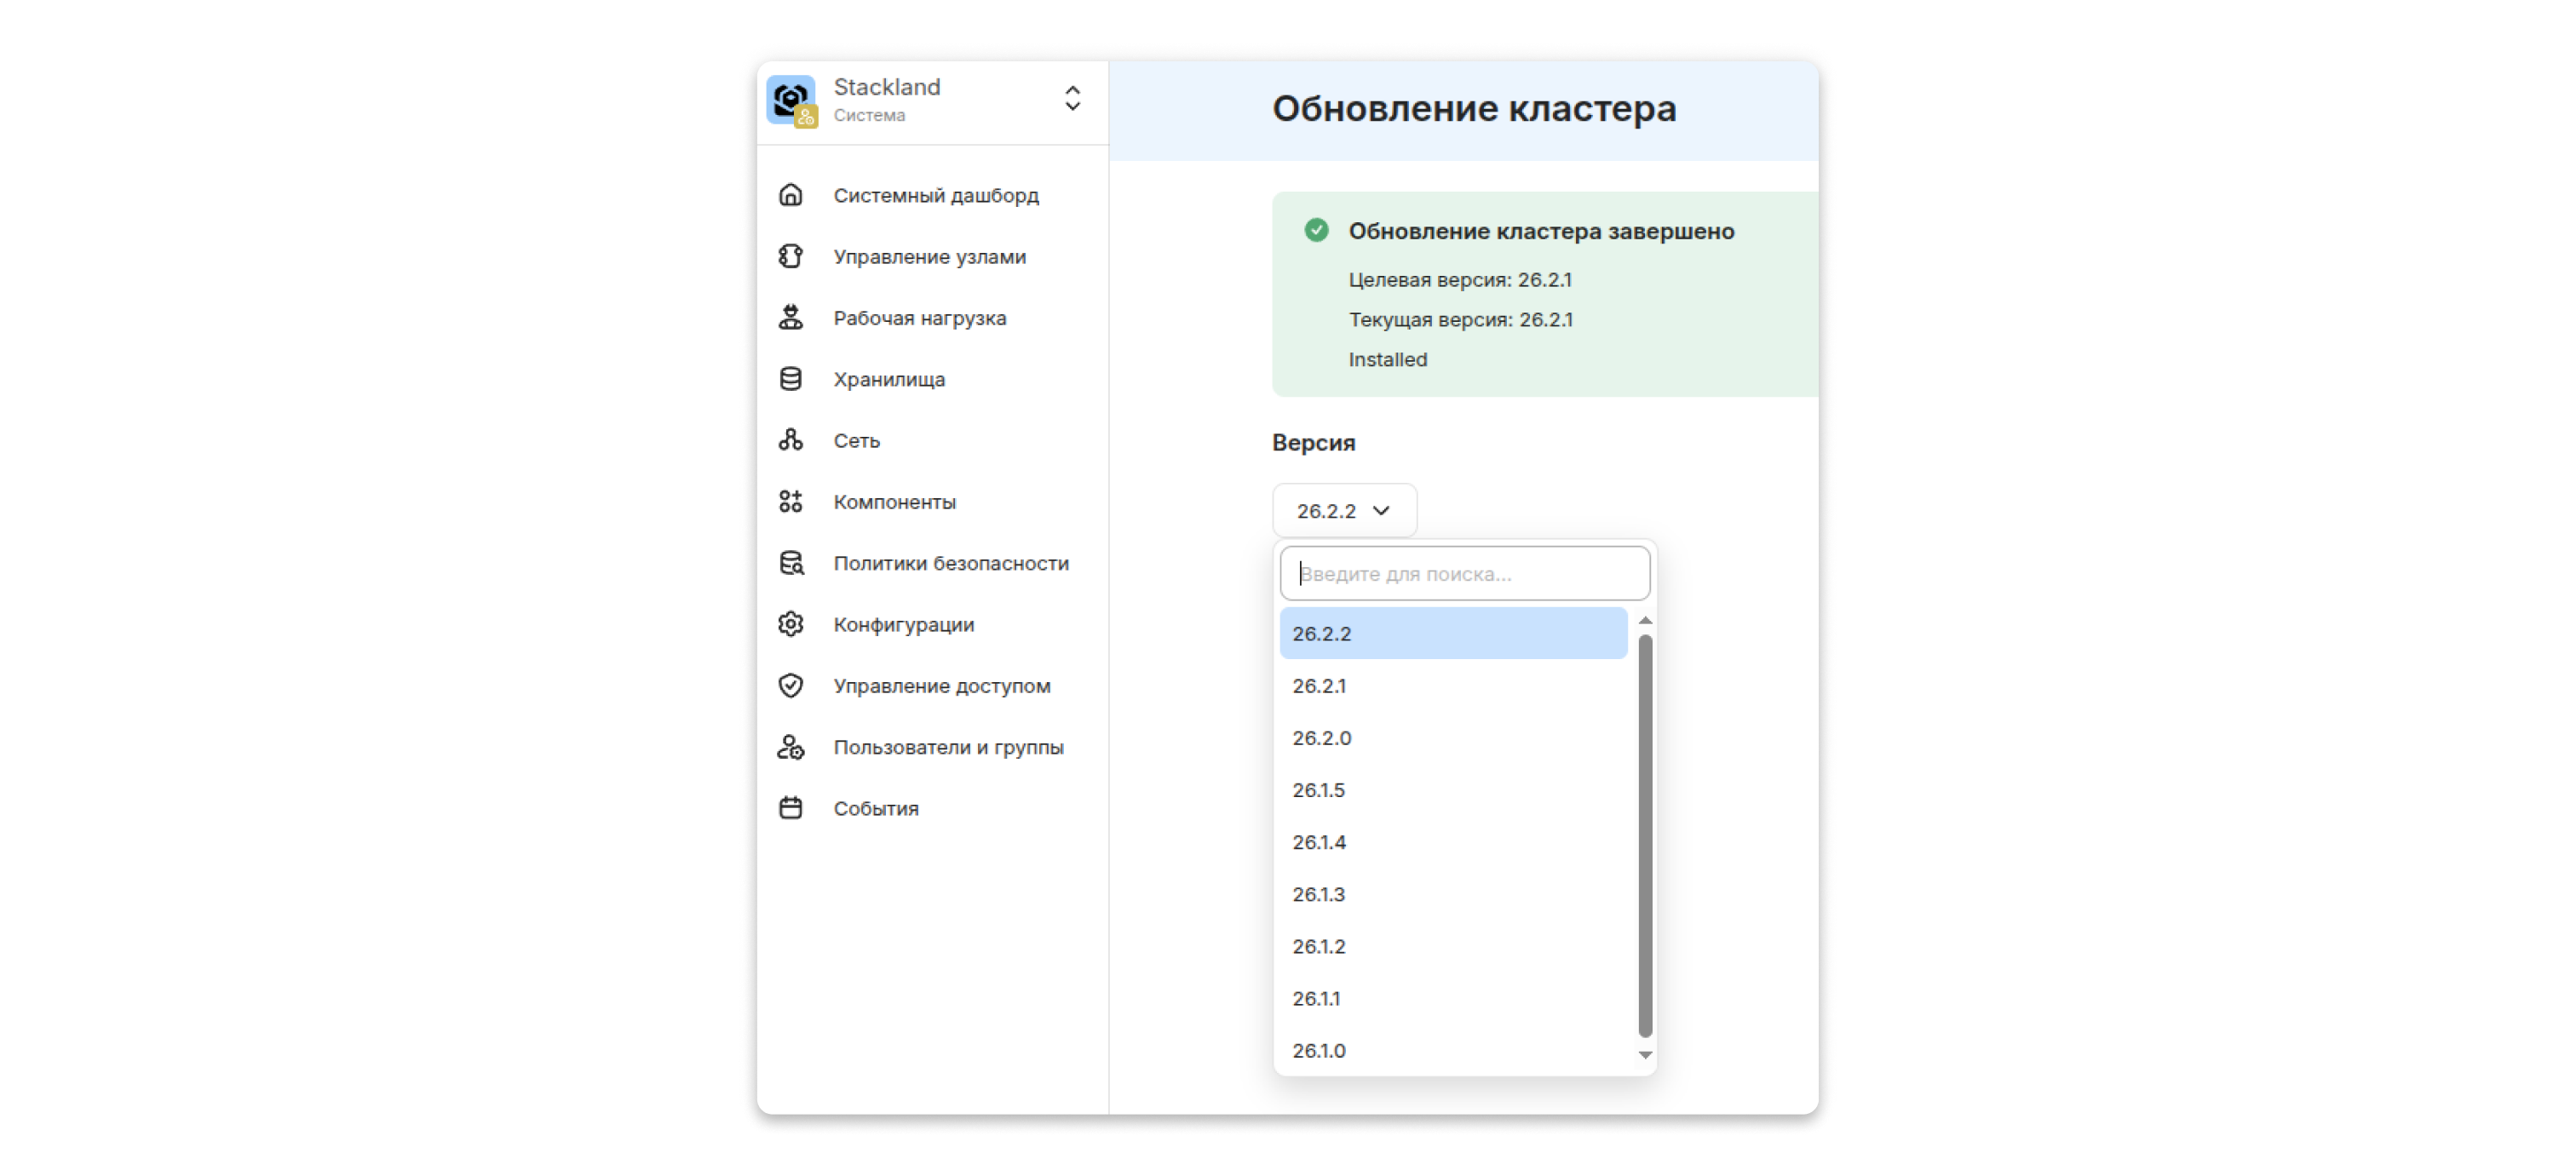
Нажмите ссылку Подробнее для перехода на страницу запуска обновления кластера.
-
В разделе Версия выберите версию 26.2.2.
-
Нажмите Запустить обновление.
Шаг 1. Получение текущей версии
Для проверки текущей версии кластера можно воспользоваться кастомным ресурсом targetinstallationstates:
kubectl get targetinstallationstates -o yaml | grep currentVersion
currentVersion: 26.2.1
Или проверить версии компонентов платформы:
kubectl get ComponentInstallation
NAME                       PHASE      VERSION   MESSAGE                            AGE
certificate-manager-main   Ready      26.2.1    Component is in the target state   2d17h
console-main               Ready      26.2.1    Component is in the target state   2d17h
dns-main                   Ready      26.2.1    Component is in the target state   2d17h
...
Шаг 2. Смена релизного канала обновления
Чтобы установить версию 26.2.2, смените канал обновлений на Alpha. Для этого внесите изменения в кастомный ресурс platformconfigs, заменив в нем значение поля releaseChannel на Alpha.
kubectl edit platformconfigs.stackland.yandex.cloud
Шаг 3. Получение доступных версий релиза
Проверить доступные релизы и последовательность обновлений можно командой:
kubectl get availablereleases main -o yaml
Найдите целевую версию 26.2.2 и убедитесь, что на эту версию можно перейти с текущей:
apiVersion: stackland.yandex.cloud/v1alpha1
kind: AvailableReleases
metadata:
  name: main
spec: {}
status:
...
  releases:
  - installerImage: cr.yandex/stackland/system/sladm:26.2.2
    publishedAt: "2026-08-13T08:33:47Z"
    ready: true
    upgradeFrom:
    - 26.2.1
    - 26.1.5
    version: 26.2.2
...
В примере видно, что с текущей версии 26.2.1 можно перейти на последнюю доступную 26.2.2.
Шаг 4. Запуск обновления
Создайте файл манифеста, например с помощью команды touch upgrade.yaml, и вставьте содержимое:
apiVersion: stackland.yandex.cloud/v1alpha1
kind: TargetInstallationState
metadata:
  name: main
spec:
  targetVersion: "26.2.2"
  installationTimeout: "2h"
В этом файле:
-
targetVersion— целевая версия для обновления, в данном случае 26.2.2; -
installationTimeout— максимальное время выполнения обновления.
Примените манифест:
kubectl apply -f upgrade.yaml
Мониторинг процесса обновления узлов
После запуска обновления:
-
В пространстве имен
stackland-installзапускается заданиеsladm-upgrade-main, логи которого отражают весь процесс обновления:kubectl logs -n stackland-install job/sladm-upgrade-mainПример логов обновления с разделением на этапы:
# Этап 1: запуск обновления и валидация конфигурации 2026-08-27T12:53:19.207Z INFO sladm/main.go:446 PXE boot disabled 2026-08-27T12:53:19.212Z INFO sladm/main.go:454 Starting SLADM installation process... 2026-08-27T12:53:19.214Z INFO sladm/config.go:60 Loading Stackland configurations from directory {"directory": "/config/"} 2026-08-27T12:53:19.229Z INFO sladm/config.go:70 Stackland configurations loaded and validated successfully 2026-08-27T12:53:19.229Z INFO sladm/license.go:160 In-cluster run: derived offline mode from licenseKey, license-server secrets will be materialized → Loaded release configuration: 26.2.2 2026-08-27T12:53:19.231Z INFO sladm/main.go:497 Loaded release {"version": "26.2.2"} 2026-08-27T12:53:19.231Z INFO sladm/main.go:503 Detected sladm-upgrade job pod {"hostname": "sladm-upgrade-main-kqclp"} ... # Этап 2: загрузка образов ⚠ Image bundle path stackland-26.2.2-minimal-oci does not exist, downloading images 2026-08-27T12:53:19.231Z WARN sladm/images.go:69 Image bundle path does not exist, will download images {"path": "stackland-26.2.2-minimal-oci"} 2026-08-27T12:53:19.231Z INFO sladm/images.go:74 Downloading images... {"bundle": "minimal", "registry": "cr.yandex/stackland"} → Downloading minimal image bundle (15 images) 2026-08-27T12:53:19.362Z INFO sladm/images.go:122 Downloading image bundle {"bundle": "minimal", "imageCount": 15} 2026-08-27T12:53:19.362Z INFO sladm/images.go:124 Creating image bundle folder {"path": "stackland-26.2.2-minimal-oci"} ✓ Fetched the manifests for all images → Saving 15 images to OCI layout: stackland-26.2.2-minimal-oci → Pulled 2/15 images (10%) ... → Pulled 15/15 images (100%) ✓ Successfully saved 15 images to stackland-26.2.2-minimal-oci 2026-08-27T12:55:24.556Z INFO sladm/images.go:132 Image bundle download completed {"path": "stackland-26.2.2-minimal-oci", "imageCount": 15} 2026-08-27T12:55:24.556Z INFO sladm/images.go:87 Image bundle downloaded successfully 2026-08-27T12:55:24.556Z INFO sladm/images.go:90 Successfully loaded image bundle {"imageCount": 15} ... # Этап 3: последовательное обновление узлов ## Инициализация Creating COSI resources from configuration... Starting COSI runtime... Created ClusterConfig resource Created PlatformConfig resource {"platform": "baremetal"} Created StacklandHostConfig resource for node {"hostname": "node1.proxmox.internal", "role": "combined"} Created StacklandHostConfig resource for node {"hostname": "node2.proxmox.internal", "role": "combined"} Created StacklandHostConfig resource for node {"hostname": "node3.proxmox.internal", "role": "combined"} Created EtcdBootstrapper resource {"hostname": "node1.proxmox.internal"} Created IntermediateCA resource Created StacklandClusterConfig resource Created StacklandSecretsConfig resource Running pre-installation node config checks... Starting Stackland 26.2.2 release reconciliation Installation workflow started, waiting for completion... {"installationTimeout": 7200, "recoveryTimeout": 600} ... ## Подключение к Talos API Created initial NodeInstallationStatus {"controller": "NodeInstallationController", "namespace": "sladm-manager", "type": "MachineStatuses.sladm.yandex.cloud", "id": "node1.proxmox.internal", "job": "reconcile", "hostname": "node1.proxmox.internal"} ... ## Пуш образов в local registry Pushing images to node local registry {"controller": "NodeInstallationController", "namespace": "sladm-manager", "type": "MachineStatuses.sladm.yandex.cloud", "id": "node1.proxmox.internal", "job": "reconcile", "hostname": "node1.proxmox.internal", "nodeIP": "172.19.11.136", "registry": "node1.proxmox.internal:5001", "imageCount": 14} → Pushing 14 images to node1.proxmox.internal:5001 ✓ Successfully pushed 14 images to node1.proxmox.internal ... ## Запуск kubelet Service start requested {"controller": "NodeInstallationController", "namespace": "sladm-manager", "type": "MachineStatuses.sladm.yandex.cloud", "id": "node1.proxmox.internal", "job": "reconcile", "hostname": "node1.proxmox.internal", "service": "kubelet"} ... ## Настройка системных компонентов и перезагрузка → Node node1.proxmox.internal: Empty → Configuring (Node is running and ready, starting post-installation configuration) → Initiating machine config update with reboot on node node1.proxmox.internal Applied machine config patches with reboot {"controller": "NodeInstallationController", "namespace": "sladm-manager", "type": "MachineStatuses.sladm.yandex.cloud", "id": "node1.proxmox.internal", "job": "reconcile", "hostname": "node1.proxmox.internal", "nodeIP": "172.19.11.136"} Post-installation configuration triggered a reboot {"controller": "NodeInstallationController", "namespace": "sladm-manager", "type": "MachineStatuses.sladm.yandex.cloud", "id": "node1.proxmox.internal", "job": "reconcile", "hostname": "node1.proxmox.internal"} Post-installation configuration triggered a reboot, waiting for node to restart {"controller": "NodeInstallationController", "namespace": "sladm-manager", "type": "MachineStatuses.sladm.yandex.cloud", "id": "node1.proxmox.internal", "job": "reconcile", "hostname": "node1.proxmox.internal"} Node successfully rebooted after configuration change {"controller": "NodeInstallationController", "namespace": "sladm-manager", "type": "MachineStatuses.sladm.yandex.cloud", "id": "node1.proxmox.internal", "job": "reconcile", "hostname": "node1.proxmox.internal"} ... # Этап 4: завершение работы задания обновления Node node2.proxmox.internal reconciled successfully Node node3.proxmox.internal reconciled successfully Node node1.proxmox.internal reconciled successfully → Node node2.proxmox.internal: Configured → Ready (All components are ready, node installation complete) → Node node1.proxmox.internal: Configured → Ready (All components are ready, node installation complete) → Node node3.proxmox.internal: Configured → Ready (All components are ready, node installation complete) ✓ Your Stackland cluster is ready Installation completed: success=true ✓ Reconciliation completed successfully Clusteradmin kubeconfig is now available at /root/.kube/config -
Появляется ресурс
targetinstallationstate, с помощью которого можно отслеживать общий статус обновления:kubectl get targetinstallationstate mainNAME TARGET VERSION CURRENT VERSION PHASE MESSAGE AGE main 26.2.2 26.2.2 Completed Successfully upgraded to version 26.2.2, all components ready 2d19hДля получения более подробной информации выполните:
kubectl describe targetinstallationstate mainВ поле
statusотображается:-
currentVersion— текущая установленная версия. -
phase— фаза обновления:-
Pending— обновление ожидает запуска; -
Running— обновление выполняется; -
Completed— обновление выполнено; -
Failed— обновление завершилось с ошибкой.
-
-
message— сообщение о текущем состоянии. -
jobName— имя задания Kubernetes, выполняющего обновление. -
lastUpdateTime— время последнего обновления статуса.
-
Мониторинг процесса обновления компонентов
После того как sladm завершила обновление Talos и системных компонентов, управление переходит к Component Manager. Он отвечает за обновление всех платформенных компонентов.
Для отслеживания статуса компонентов в реальном времени выполните:
kubectl get componentinstallations -w
NAME                       PHASE      VERSION   MESSAGE
certificate-manager-main   Ready      26.2.2    Component is in the target state
console-main               Updating   26.2.1    Component is being updated
dns-main                   Ready      26.2.2    Component is in the target state
iam-main                   Updating   26.2.1    Component is being updated
...
После завершения обновления все компоненты должны получить статус Ready.
kubectl get componentinstallations
NAME                       PHASE   VERSION   MESSAGE                            AGE
certificate-manager-main   Ready   26.2.2    Component is in the target state   5h56m
console-main               Ready   26.2.2    Component is in the target state   5h33m
dns-main                   Ready   26.2.2    Component is in the target state   5h56m
iam-main                   Ready   26.2.2    Component is in the target state   5h48m
...
Итоги
Вы узнали, как подготовить кластер к обновлению, и проследили за процессом. Что важно запомнить:
-
Обновление Stackland идемпотентно: сначала обновляются узлы
control-plane, затемworker-узлы, а в случае прерывания процесс автоматически возобновляется. -
Для подготовки кластера к обновлению рекомендуется проверить состояние платформенных компонентов через
kubectlиtalosctl, создать резервную копиюetcdи диагностический архив. -
Совместимость версий задается в объекте
AvailableReleases, с его помощью можно проверить, какие версии доступны. -
Чтобы снизить риски для пользовательских нагрузок при обновлении, необходимо провести проверку на устаревшие Kubernetes API через
pluto, убедиться в наличииPodDisruptionBudgetдля критичных сервисов, сделать ручное резервное копирование данных. -
Чтобы снизить риски для управляемых сервисов при обновлении, учитывайте особенности каждого отдельного сервиса. Общая рекомендация — проверить здоровье кластера и сделать ручное резервное копирование данных.
-
Запустить обновление можно как через консоль управления, так и через CLI.
-
Отследить прогресс обновления можно для узлов — по логам задания обновления
sladm-upgrade-main— и для платформенных компонентов — с помощью ресурсаComponentInstallation.
Будем благодарны за обратную связь — это поможет нам улучшить рецепты. Опрос займет не более 3 минут.